Pourquoi ce projet
Deux raisons, dans cet ordre. La première : je voulais me confronter à de vraies difficultés techniques et mener un projet complet de bout en bout, de la première ligne de code jusqu'à des utilisateurs réels qui s'en servent tous les jours pendant un mois. Pas une démo, pas un tutoriel suivi ligne à ligne. Quelque chose qui devait fonctionner tout seul, y compris à 3 h du matin quand un match se terminait sans que personne ne surveille.
La seconde : j'aime le foot, et une Coupe du monde à 48 équipes offrait un prétexte parfait. Un calendrier public, des scores qui tombent en continu, une structure de compétition tordue à modéliser, et un petit groupe de joueurs motivés pour tester l'application en conditions réelles.
Tout a été écrit dans la semaine qui précédait le coup d'envoi, en dehors de mes heures de travail. Aucune phase de test : la première version a été mise en ligne, les joueurs se sont inscrits, et le tournoi a commencé. Tout ce qui suit a donc été corrigé et complété pendant la compétition, au fil de ce que les participants remontaient et de ce que je voyais casser en direct.
Certaines décisions sont des choix assumés, d'autres sont ce que j'ai pu faire tenir en deux heures un soir de semaine avec un match à 21 h. Je distingue les deux dans la dernière section.
Le cadre était contraint dès le départ, et c'est précisément ce qui rendait l'exercice intéressant :
- Un hébergement mutualisé classique, en PHP. Pas de conteneur, pas de processus long, pas de serveur applicatif à configurer.
- Un seul créneau de tâche planifiée chez l'hébergeur, à partager avec mes autres projets.
- Budget zéro pour les données. Toutes les sources devaient être gratuites, ce qui veut dire des quotas serrés et des API non documentées.
- Une utilisation majoritairement mobile, en situation : dans le canapé, dix minutes avant le coup d'envoi.
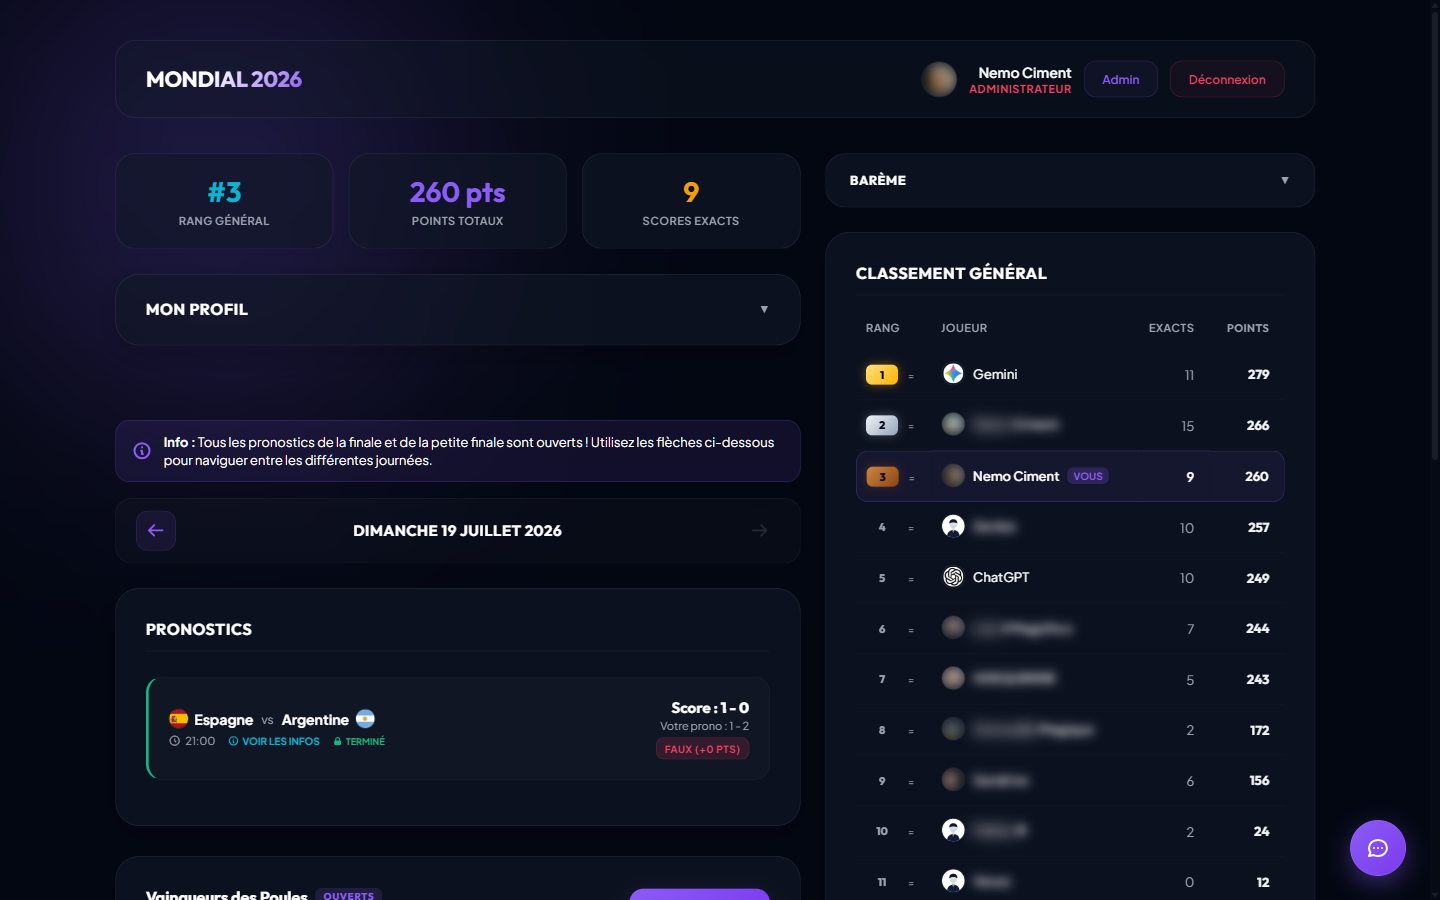
Une précision sur les captures de cette page, pour éviter la question : deux comptes un peu particuliers ont participé au jeu. J'ai fait pronostiquer ChatGPT et Gemini sur les 104 matchs et je les ai inscrits comme des joueurs ordinaires, ce qui explique leur présence dans les classements ci-dessous. L'application ne les traite différemment que sur un point : les rappels de pronostic les excluent explicitement, puisqu'ils n'ont pas de téléphone à faire sonner.
Une architecture sans base de données
Le premier arbitrage a été de se passer complètement de base de données. Tout l'état du jeu tient dans des fichiers JSON posés dans un dossier /data protégé par un fichier .htaccess : le calendrier et les scores dans fixtures.json, les comptes et leurs points dans users.json, les pronostics dans predictions.json, et ainsi de suite pour le chat, le sondage et les statistiques d'avant-match.
Ce choix se défend pour un jeu à quatorze comptes : aucune migration à gérer, une sauvegarde qui se résume à copier un dossier, et surtout la possibilité d'ouvrir un fichier pour comprendre exactement ce que l'application croit savoir. Il a aussi ses limites, et j'y reviens plus bas.
La mécanique repose sur deux déclencheurs distincts, et c'est le point le plus structurant de l'architecture. Les scores se rafraîchissent quand quelqu'un consulte l'application, ce qui les rend immédiats sans rien coûter quand personne ne regarde. Les rappels de pronostic, eux, doivent partir à l'heure même si l'application est déserte, et dépendent donc d'une tâche planifiée.
Deux déclencheurs, deux chaînes. Les scores suivent le trafic, les rappels suivent l'horloge.
Récupérer 104 matchs sur une API non documentée
Les scores viennent du tableau de bord public d'ESPN, une API gratuite mais officieuse : aucune documentation, aucune garantie de stabilité, et une limite implicite d'une centaine d'événements par réponse. Avec 104 matchs au programme, la première requête tronquait déjà le tournoi. La parade tient en une ligne : découper la période en deux appels, du 11 juin au 5 juillet puis du 6 au 19 juillet, et fusionner les résultats.
Le vrai problème est arrivé juste après. Pour reporter un score sur le bon match, encore faut-il savoir de quel match il s'agit, et les identifiants ne concordaient pas toujours : certaines affiches n'existaient pas encore côté ESPN quand le calendrier local a été initialisé, et les noms d'équipes arrivaient en anglais, avec des accents cassés et des variantes selon les jours.
Aucune clé de rapprochement fiable entre le calendrier local et les événements renvoyés par l'API, notamment pour les matchs dont les équipes ne sont pas encore connues.
Une cascade à trois niveaux, du plus fiable au plus tolérant. Chaque niveau ne s'exécute que si le précédent a échoué, et les noms d'équipes sont normalisés vers une orthographe française unique avant toute comparaison, ce qui neutralise les accents cassés et les variantes de l'API.
Trois niveaux de rapprochement. Si aucun ne correspond, le match est simplement créé.
La synchronisation ne réécrit les fichiers que si quelque chose a réellement changé : un score, un statut, une heure de coup d'envoi, une horloge de match en cours. Sans cette précaution, chaque passage aurait réécrit l'intégralité du calendrier pour rien, à chaque appel.
Le classement bouge pendant le match
C'est la fonctionnalité qui a le plus changé la façon dont le groupe utilisait l'application. Une tâche planifiée seule n'aurait pas suffi : entre deux passages, le score affiché aurait toujours eu plusieurs minutes de retard, ce qui tue l'intérêt de regarder un match avec le classement ouvert à côté.
La synchronisation est donc déclenchée par le trafic. À chaque ouverture de page, l'application regarde si une rencontre a déjà démarré sans être terminée. Si c'est le cas, elle interroge la source de scores et met à jour l'affichage dans la même seconde. Autrement dit, le score est frais au moment où on le regarde, pas au moment du dernier passage automatique.
Si chaque visite déclenche un appel, dix personnes qui rafraîchissent pendant un France-Norvège en déclenchent dix, simultanés. De quoi saturer la source et réécrire le même fichier depuis dix processus à la fois.
Deux garde-fous qui se complètent. Un intervalle minimum de 30 secondes entre deux interrogations, quel que soit le nombre de visiteurs. Et un verrou de fichier non bloquant : le premier arrivé prend la main et va chercher les scores, les autres ne patientent pas et affichent immédiatement les dernières données connues. Un verrou resté coincé plus de quinze secondes est considéré comme périmé et libéré.
Le résultat, côté joueur : la carte du match affiche la minute de jeu, le score du moment et un point qui pulse. Et surtout, un match en cours compte immédiatement dans le calcul des points, au même titre qu'un match terminé. Un but à la 70e minute fait bouger le classement général avant le coup de sifflet final, et l'application conserve pour chaque joueur son rang précédent afin d'afficher le mouvement. Concrètement, on voyait en direct qui prenait la tête sur un but et qui la reperdait sur le suivant. Le jeu se suivait autant que le match.
Les points restent comptabilisés séparément selon que le match est terminé ou en cours, de sorte qu'un score qui bouge en fin de rencontre corrige le classement au lieu de s'y ajouter. En dehors des périodes de match, l'application se contente d'une synchronisation par jour : inutile d'interroger une source de scores en direct un mardi matin.
Reconstruire l'arbre de la phase finale
Un tournoi à 48 équipes produit une phase finale à sept tours, des seizièmes jusqu'à la finale, plus un match pour la troisième place. Tant que les qualifiés ne sont pas connus, l'API renvoie des affiches provisoires, et elle les renvoyait mal : des appariements incohérents, des équipes placées dans la mauvaise moitié de tableau. Reporter ces données telles quelles aurait affiché des demi-finales fantaisistes pendant des jours.
J'ai donc cessé de faire confiance à l'API sur ce point précis et reconstruit l'arbre localement. Le principe : ne plus lire les affiches annoncées, mais les déduire des résultats. Dès qu'une rencontre est terminée, son vainqueur descend automatiquement au tour suivant ; tant qu'elle ne l'est pas, l'application affiche un libellé de repli explicite du type « Vainqueur France/Suède » plutôt qu'une affiche inventée. Le match pour la troisième place suit la même logique en récupérant les perdants des demi-finales.
L'arbre est ainsi toujours cohérent avec ce qui s'est réellement passé sur le terrain, et il se remplit tour par tour au fil de la compétition sans intervention.
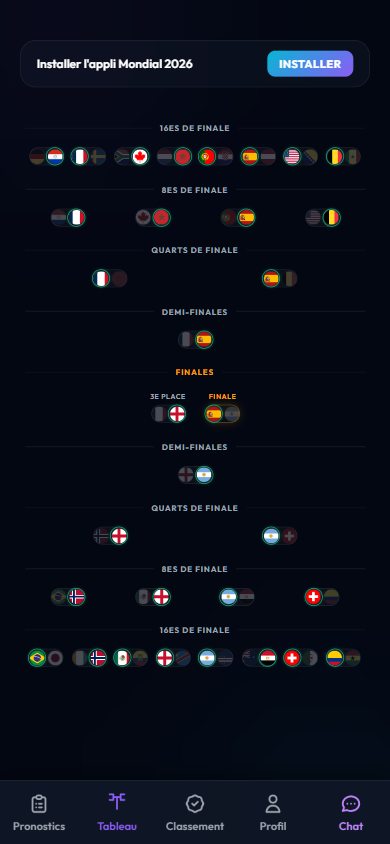
L'arbre complet tient dans un écran de téléphone, des seizièmes à la finale et en miroir. Il est reconstruit à partir des résultats plutôt que des affiches annoncées par l'API.
Le barème, le classement et un sondage
Le barème récompense la précision par paliers : 4 points pour un score exact, 3 points si le vainqueur et l'écart de buts sont bons, 2 points pour le bon vainqueur seul, et rien du tout sinon. Deviner le vainqueur de chaque poule rapporte 2 points supplémentaires. À partir de la phase à élimination directe, tous les points sont doublés.
Ce doublement n'était pas ma décision. Il change complètement la dynamique de fin de tournoi, puisqu'il permet à un joueur distancé de tout rattraper sur huit matchs. Plutôt que de trancher seul, j'ai intégré un sondage à l'application : chaque participant votait pour un coefficient simple ou doublé, et le résultat s'appliquait à tout le monde. Six votes exprimés, quatre pour le doublement.
Le classement se recalcule intégralement à chaque synchronisation, en repartant de zéro et en reparcourant tous les pronostics. C'est volontairement bête et coûteux, mais l'opération est idempotente : corriger un score dans l'interface d'administration suffit à remettre l'ensemble du classement d'aplomb, sans script de rattrapage. Les égalités sont départagées au nombre de scores exacts, et l'application conserve le rang précédent de chaque joueur pour afficher les mouvements après chaque match.
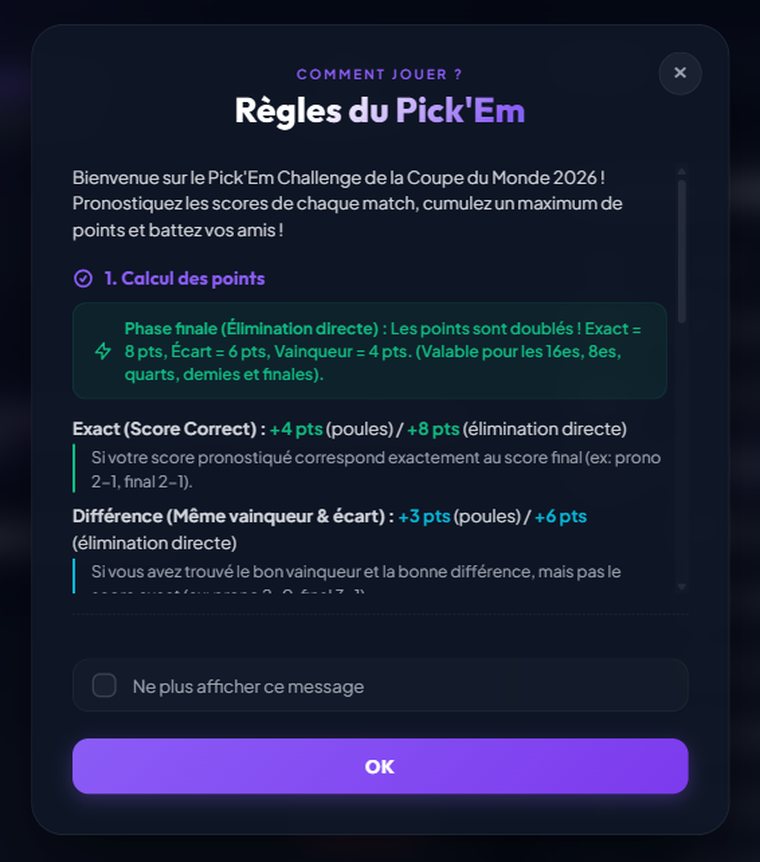
Le barème, rappelé à la première connexion.
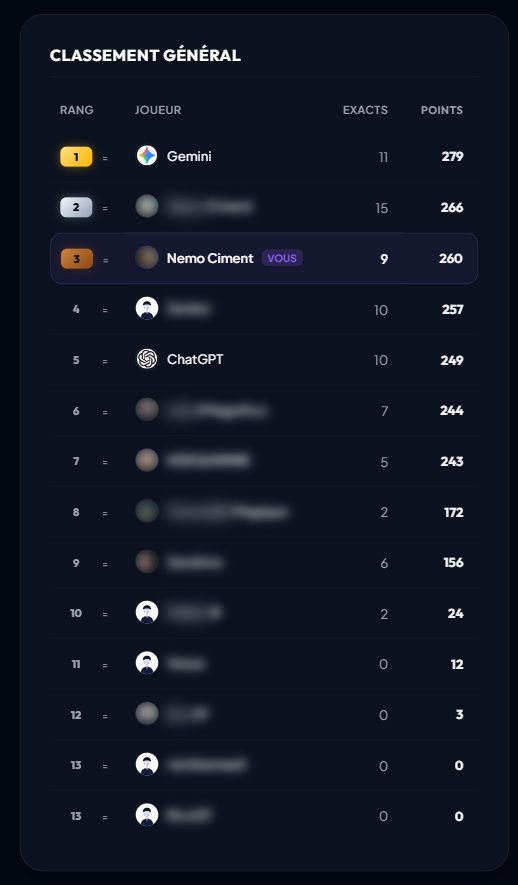
Le classement général en fin de tournoi.
Une fois un match verrouillé, tout le monde voit tout : le pronostic de chaque joueur et les points qu'il a rapportés, triés du meilleur résultat au plus mauvais. C'est la fonctionnalité la plus consultée du jeu, et de loin.
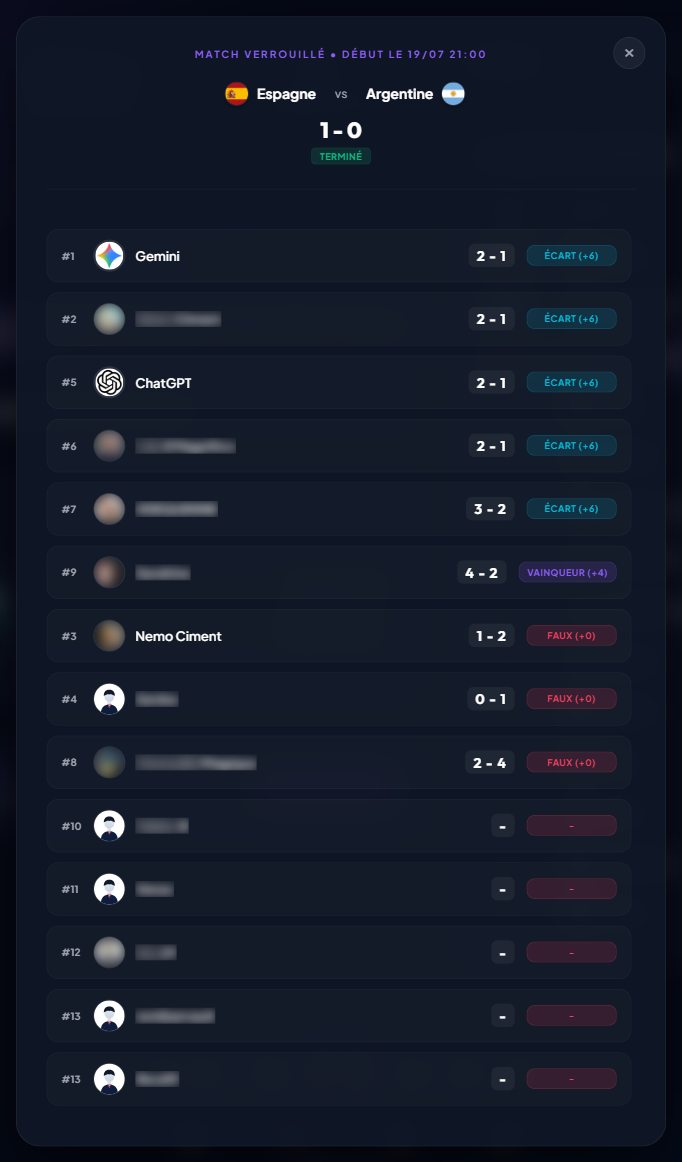
Les pronostics de la finale, une fois le match verrouillé.
Les cotes et la simulation de paris
Je voulais afficher une cote sur chaque match, et surtout proposer une simulation de paris fictifs : combien un joueur aurait gagné ou perdu s'il avait misé sur ses propres pronostics. Pour que le chiffre veuille dire quelque chose, il fallait des cotes réelles.
L'application récupère donc les cotes réelles du match auprès d'une source externe, et les stocke aux côtés du score, dans le même fichier. Chaque rencontre embarque ses trois cotes de résultat : victoire à domicile, match nul, victoire à l'extérieur.
Le reste est de la comptabilité. Pour chaque match terminé, l'application relit le pronostic du joueur, en déduit le vainqueur qu'il annonçait, et rejoue le pari comme s'il avait misé 10 € dessus à la cote réelle du moment. Elle cumule ensuite les mises et les gains sur tout le tournoi pour afficher un bilan.
C'est un chiffre qui en dit plus que le classement. Un joueur peut très bien être devant aux points en misant systématiquement sur les favoris, tout en étant largement perdant en euros, parce que les favoris rapportent peu. À l'inverse, deux ou trois pronostics osés qui tombent juste suffisent à renverser le bilan. Le classement récompense la régularité, la simulation récompense la prise de risque, et les deux ne désignent pas le même vainqueur.
Le bilan reste d'ailleurs masqué jusqu'à ce qu'on le découvre volontairement, pour éviter d'afficher un chiffre parfois cruel en permanence sur la page de profil.
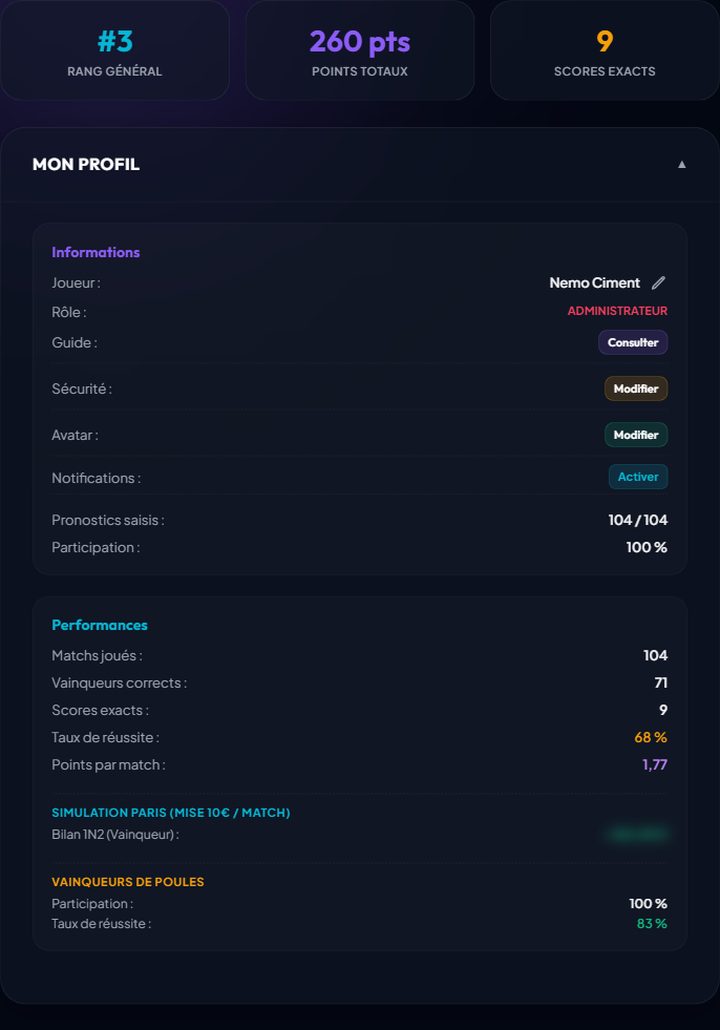
Le profil joueur, avec le bilan de la simulation de paris masqué par défaut.
La fiche d'avant-match : quatre sources en une vue
C'est la partie qui m'a demandé le plus de travail, et celle que je trouve la plus aboutie. Avant chaque rencontre, l'application rassemble en une seule fiche ce qui aide réellement à pronostiquer : classement FIFA des deux nations, valeur marchande et âge moyen de l'effectif avec leur rang parmi les 48 équipes, joueurs blessés ou suspendus, forme récente, confrontations passées, classement de la poule, diffuseurs télé et météo prévue au stade.
Quand les compositions officielles tombent, une heure avant le coup d'envoi, la fiche affiche les deux équipes disposées sur un terrain. Le placement s'adapte au schéma tactique de chaque sélection, d'un 4-4-2 à un 4-2-3-1, avec les numéros de maillot, le capitaine, les remplaçants et la valeur du onze aligné.
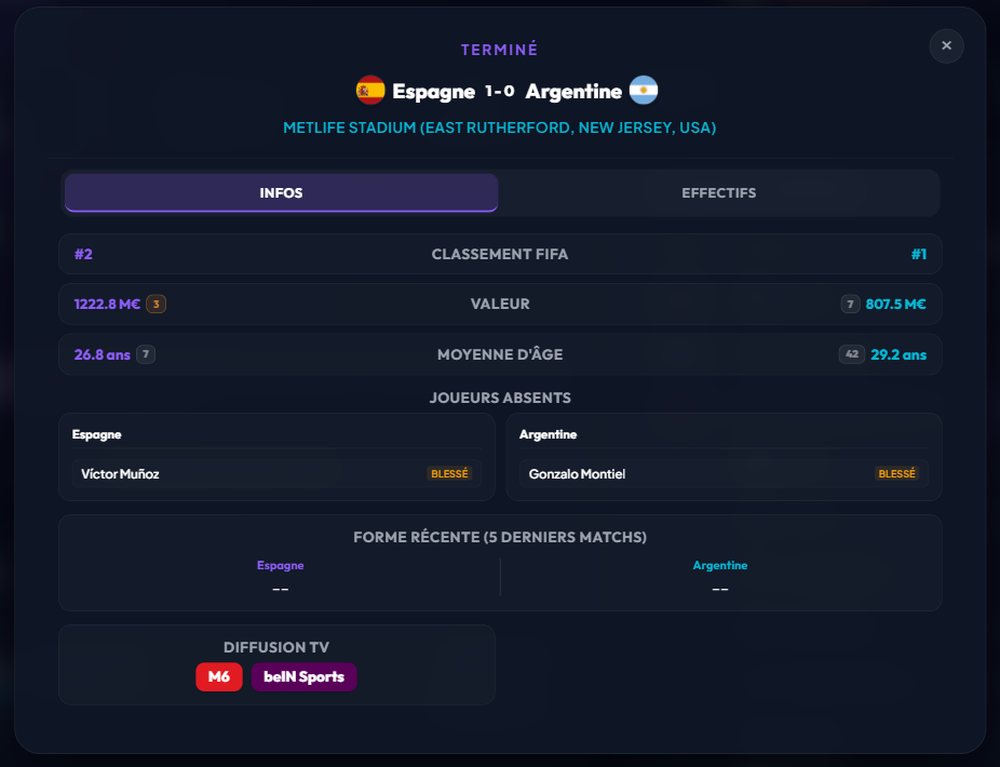
Les données d'avant-match, agrégées depuis plusieurs sources. Les deux chiffres en pastille situent chaque équipe parmi les 48 du tournoi.
L'onglet Effectifs est la partie la plus dense. Il ne se contente pas d'afficher un onze : il récupère l'effectif complet des deux sélections, place les titulaires sur le terrain à leur poste réel, chiffre la valeur du onze aligné de chaque côté, et liste les remplaçants avec leur numéro et leur position. Un sélecteur permet de basculer d'une équipe à l'autre pour le banc.
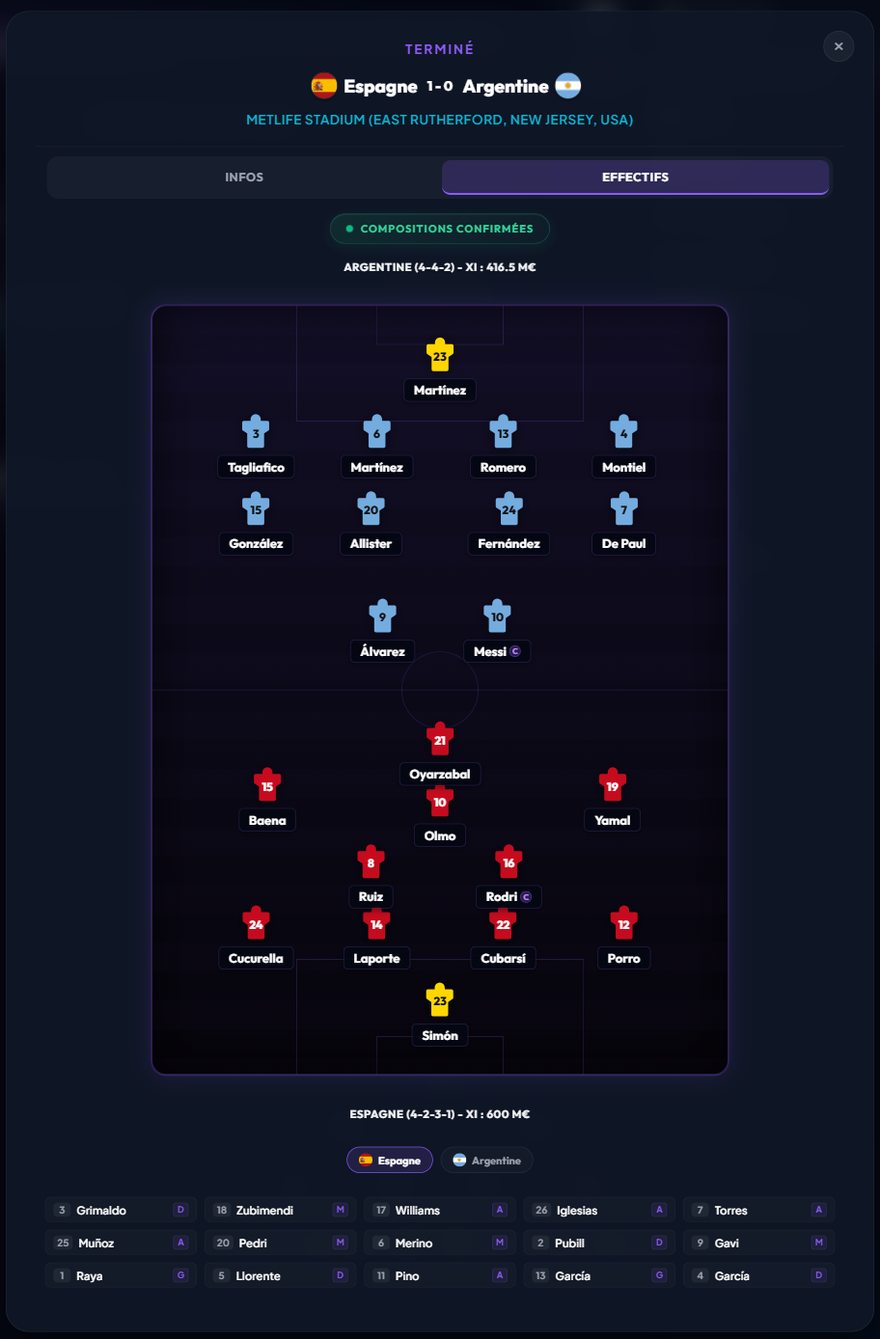
L'onglet Effectifs en entier : les deux formations face à face avec la valeur de chaque onze, puis le banc de l'équipe sélectionnée, poste par poste.
La météo illustre bien le genre de détail qui prend plus de temps que prévu. Les stades ne sont identifiés que par le nom de leur ville, avec des libellés inconstants d'une rencontre à l'autre. L'application résout donc ce nom en coordonnées géographiques, avec un repli sur un service de géocodage gratuit quand elle ne reconnaît pas le libellé. Une fois le point connu, elle va chercher les prévisions horaires et retient le relevé le plus proche du coup d'envoi, en renonçant si l'écart dépasse six heures plutôt que d'afficher une prévision hors sujet.
Une réserve sur les captures de cette section, et c'est dommage : deux blocs y apparaissent vides. La météo au stade se masque d'elle-même une fois le match joué, et la forme récente sur les cinq derniers matchs ne renvoie plus que des tirets. Le tournoi étant terminé depuis juillet, il n'en reste aucune trace capturable, alors qu'en conditions réelles ces deux blocs faisaient partie de ce qu'on regardait le plus avant un match.
Tenir dans les quotas gratuits
Les compositions, les blessés et les valeurs d'effectif viennent d'une seconde source, dont l'offre gratuite plafonne à cinquante requêtes par jour. Sur une journée à quatre matchs, avec deux équipes chacun, le budget part vite. Plusieurs garde-fous se combinent pour ne jamais le dépasser.
- Une fenêtre de synchronisation étroite. Les données d'effectif ne sont rafraîchies que dans les douze heures précédant le coup d'envoi, une seule fois par équipe et par match. En dehors de cette fenêtre, aucun appel n'est émis.
- La lecture du quota restant. Chaque réponse renvoie le nombre de requêtes disponibles dans ses en-têtes. L'application le stocke et refuse de repartir en appel quand il approche de zéro.
- La rotation de clés. Deux clés sont configurées. Dès qu'une réponse revient en dépassement de quota, l'application bascule sur la suivante et réessaie immédiatement, sans intervention.
- L'horodatage avant l'appel. La date de dernière synchronisation est écrite avant d'émettre la requête. Si l'API ne répond pas, ou si le match reste introuvable, l'application ne retentera pas en boucle à chaque visite.
- Un cache sur disque. Les réponses détaillées des matchs sont conservées telles quelles, ce qui évite de réinterroger la source pour afficher une fiche déjà consultée.
Le mécanisme a tenu tout le tournoi sans que je touche à la configuration.
Des notifications qui ne réveillent que les bonnes personnes
Un jeu de pronostics vit ou meurt sur un détail : est-ce que les joueurs pensent à valider avant le coup d'envoi. Une notification générique envoyée à tout le monde avant chaque match aurait été insupportable au bout de trois jours, avec quatre rencontres quotidiennes en phase de poules.
Le rappel est donc calculé. À chaque passage, la tâche planifiée repère les matchs qui commencent dans vingt à trente-cinq minutes, dresse la liste des joueurs qui n'ont pas encore saisi de pronostic pour cette rencontre précise, et n'envoie la notification qu'à ceux-là, nommément, via leur identifiant de compte. Un joueur à jour de ses pronostics ne reçoit jamais rien. Le message nomme l'affiche concernée et renvoie directement sur la bonne section de l'application.
Une garde empêche le doublon : l'identifiant du match est archivé dès le premier envoi, ce qui évite qu'un second passage de la tâche planifiée dans la même fenêtre ne relance tout le monde. Sur l'ensemble du tournoi, 476 rappels ont été envoyés pour 92 matchs.
Un seul créneau planifié pour plusieurs projets
L'hébergement ne proposait qu'une seule tâche planifiée, déjà occupée par d'autres projets. Le pick'em n'a donc pas eu droit à son propre créneau : ses traitements sont enchaînés à la suite des autres, depuis un point d'entrée unique appelé toutes les dix minutes.
Ce montage a une faiblesse que j'ai découverte en production : tant que les maillons s'enchaînent dans le même script, une erreur fatale au milieu emporte tout ce qui vient après. Une panne dans un traitement sans rapport suffisait à priver les joueurs de leurs rappels, sans le moindre signal. Chaque maillon a fini par être isolé pour échouer seul, et le journal d'exécution sert de preuve que la chaîne tourne : un peu plus de dix mille passages sur la durée du tournoi, à dix minutes d'intervalle.
Une application, pas un site
L'usage réel étant mobile, l'application est installable sur l'écran d'accueil : manifeste, agent de service, bannière d'installation proposée au bon moment. Une fois posée sur le téléphone, elle s'ouvre en plein écran, sans barre d'adresse, et reçoit les notifications comme une application native.
L'interface change de logique selon la taille de l'écran. Sur ordinateur, tout est visible d'un coup, en deux colonnes. Sur téléphone, une barre de navigation basse à cinq entrées prend le relais et les fenêtres remontent depuis le bas de l'écran. Un détail à connaître : l'agent de service laisse délibérément passer les requêtes vers d'autres domaines sans les intercepter, pour contourner un défaut du navigateur d'iOS qui faisait échouer le chargement des drapeaux.
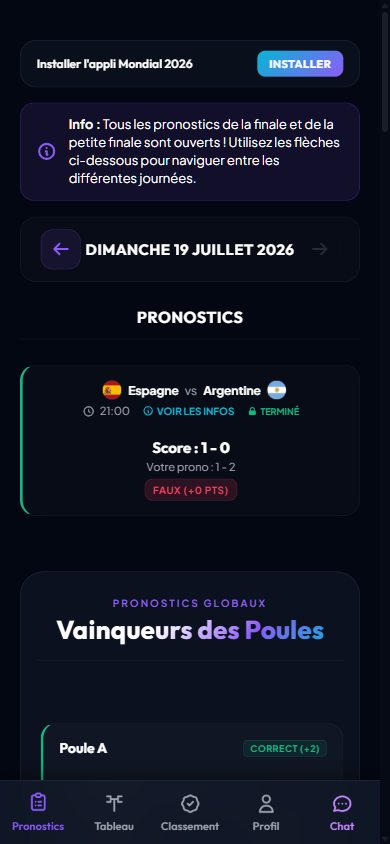
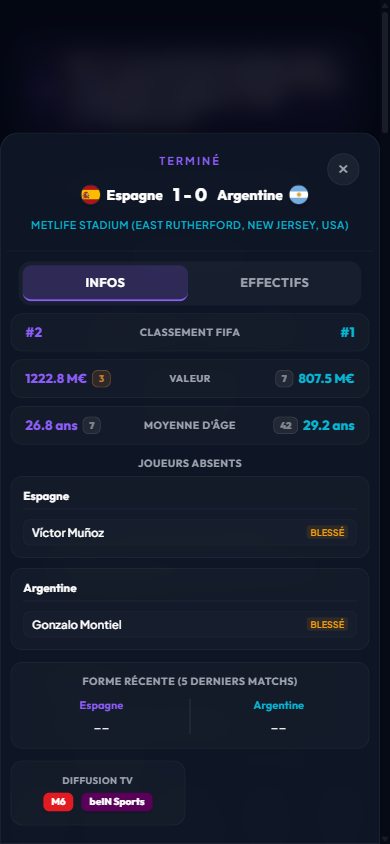
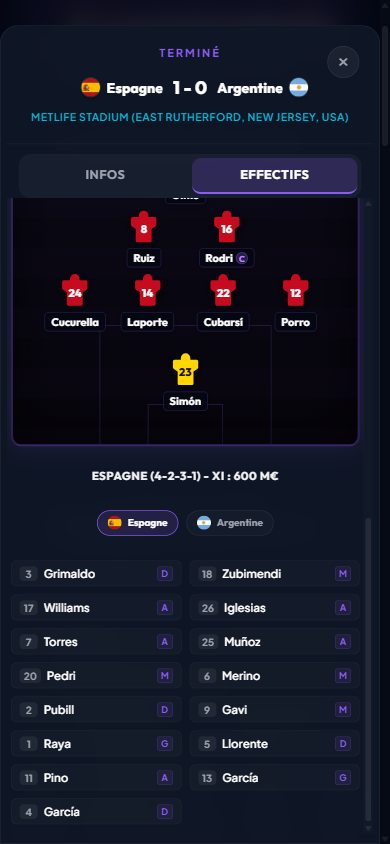
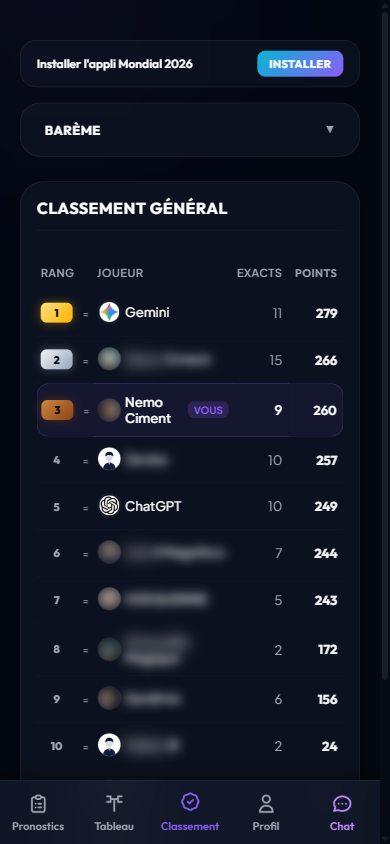
Les mêmes fonctionnalités, réagencées pour le pouce. Faites défiler la bande horizontalement.
Le reste relève de la vie de groupe : une discussion intégrée avec compteur de messages non lus et modération pour l'administrateur, des avatars personnalisables par photo recadrée ou silhouette au drapeau du pays, un pseudonyme modifiable et une récupération de mot de passe par question secrète. Les mots de passe et les réponses secrètes sont hachés avec l'algorithme recommandé par PHP.
Ce que je referais autrement
Le projet a atteint son but, ce qui n'empêche pas d'être lucide sur ses faiblesses. Une semaine de développement avant le coup d'envoi, sans phase de test et en dehors des heures de travail, ça se voit à certains endroits.
- Les fichiers JSON auraient dû devenir une base SQLite. Le stockage en fichiers plats a très bien tenu à quatorze comptes, mais rien ne protège deux écritures simultanées sur le même fichier. Avec dix fois plus de joueurs, le risque de perdre un pronostic devient réel. SQLite aurait coûté le même effort et réglé la question.
- Les avatars n'ont rien à faire dans le fichier des comptes. Les photos sont stockées encodées en texte, directement dans le fichier lu à chaque affichage de page. Des fichiers image posés sur le disque auraient été plus légers et plus simples à servir.
- Le fichier principal est devenu un monolithe. Onze mille lignes qui mélangent le rendu, la logique de jeu et les points d'entrée appelés en arrière-plan. Ça fonctionne, ça se relit mal, et chaque ajout demande plus de prudence que le précédent.
- Les clés d'API vivent en clair dans un fichier de configuration versionné. Acceptable pour un jeu entre proches sur un serveur privé, à proscrire dès que le projet change d'échelle.
Ces quatre points ont un caractère commun : aucun n'était un problème à l'échelle du jeu, tous le seraient devenus à l'échelle suivante. Les identifier en les vivant plutôt qu'en les lisant, c'est exactement ce que je cherchais en montant ce projet.