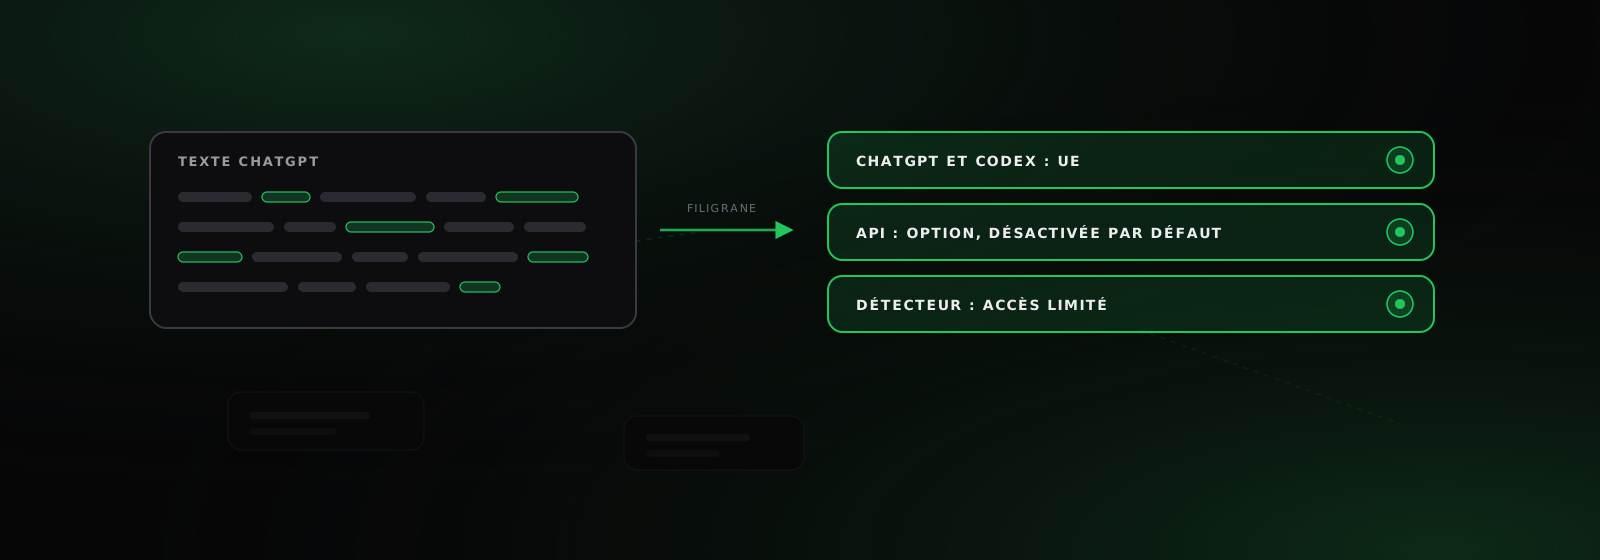
OpenAI a annoncé le 5 octobre 2026 qu'un filigrane invisible, textGrain, sera ajouté dans les semaines à venir aux textes ChatGPT et Codex des utilisateurs de l'Union européenne, pour répondre à l'article 50 de l'AI Act. Le signal se loge dans le choix des mots. Le détecteur est réservé à des chercheurs et organismes approuvés, et son taux passe d'environ 92 % à 17 % quand 25 % des mots d'un passage de 400 tokens sont remplacés par des synonymes. Google demande de vérifier le contenu généré par IA avant de le publier, et c'est la relecture humaine qui répond à cette demande.
Sommaire
OpenAI a publié le 5 octobre 2026 son approche des règles européennes de provenance des textes1, et Search Engine Journal l'a reprise le 6 octobre.2 Pour une PME qui fait rédiger les pages de son site avec ChatGPT, la question est de savoir ce que ce marquage change pour son référencement et pour ses contrats. Cet article reprend ce qui sera marqué, ce que le détecteur peut établir, ce que dit la page de Google sur le contenu généré par IA, et la place que garde la relecture humaine.
01Ce qui sera marqué, et par qui
L'obligation vient de l'article 50 de l'AI Act, applicable depuis le 2 août 2026. Les fournisseurs de systèmes d'IA générative doivent marquer leurs sorties dans un format lisible par machine, de façon qu'elles soient détectables comme générées par une IA.3 Les systèmes mis sur le marché avant le 2 août 2026 ont jusqu'au 2 décembre 2026 pour ce marquage.3
Ce qu'OpenAI déploie
Dans les semaines à venir, OpenAI ajoutera un filigrane invisible aux textes ChatGPT et Codex éligibles, sur tous les forfaits, pour les utilisateurs de l'Union européenne seulement. Le marquage n'est pas activé par défaut dans le reste du monde au lancement.1 Dans l'API, les clients du monde entier peuvent l'activer dès maintenant pour certains modèles, l'option restant désactivée par défaut.1
| Produit | Marquage annoncé |
|---|---|
| ChatGPT et Codex, utilisateurs de l'UE | filigrane ajouté sur tous les forfaits, dans les semaines à venir1 |
| API, monde entier | option activable pour certains modèles, désactivée par défaut1 |
| Détecteur de texte | candidatures ouvertes, accès limité à des chercheurs et organismes d'experts approuvés1 |
| Images et audio | outils de vérification déjà publics, dont openai.com/verify1 |
Fournisseur et déployeur : qui doit quoi
La Commission européenne distingue le fournisseur, qui développe le système et le met sur le marché, et le déployeur, qui l'utilise sous son autorité dans un cadre professionnel.3 Marquer les sorties relève du fournisseur. Le déployeur n'a une obligation d'étiquetage visible que pour les textes publiés dans le but d'informer le public sur des sujets d'intérêt public, et seulement s'ils n'ont subi ni relecture humaine ni contrôle éditorial.3
Pour entrer dans cette obligation, un texte doit remplir trois critères cumulés : être publié, informer le public, porter sur un sujet d'intérêt public. La FAQ cite par exemple la santé publique, la sécurité des consommateurs ou la protection de l'environnement.3 Les amendes peuvent atteindre 15 millions d'euros ou 3 % du chiffre d'affaires mondial, avec une proportionnalité possible pour les PME.3
02Ce que le détecteur peut établir
OpenAI décrit textGrain comme un signal statistique ajouté aux choix de mots du modèle, que le détecteur recherche ensuite. Le billet insiste sur les limites : une bonne performance en conditions idéales ne garantit pas une détection fiable en usage courant.1
Les taux de détection d'OpenAI
OpenAI mesure la détection avec un taux de faux positifs visé de 1 %. Elle dépend de la longueur du texte et de son type.1
| Cas mesuré | Détection |
|---|---|
| Passage de 200 tokens, contenu de type psychologie | environ 80 % |
| Passage de 400 tokens, contenu de type psychologie | environ 95 % |
| Contenu de type mathématiques | nettement plus faible, le choix des mots y étant moins libre |
Ces mesures portent sur des réponses à des questions du jeu de données ELI5.1 Search Engine Journal rappelle que le Code de bonnes pratiques européen n'impose pas de marquer un texte libre de moins de 200 tokens, ce qui correspond à la longueur la plus courte des résultats d'OpenAI.2
L'effet des modifications
Sur des passages anglais de 400 tokens, remplacer 10 % des mots par des synonymes fait passer la détection d'environ 92 % à environ 66 %. Avec 25 % de mots remplacés, elle tombe à environ 17 %.1
Ce qu'une détection ne dit pas
OpenAI énumère ce qu'on ne peut pas conclure d'un résultat de détection.1
- La part humaine : un filigrane indique qu'un système d'OpenAI a généré ou traité une partie du passage, sans mesurer ce qu'une personne y a apporté.
- La propriété et la responsabilité : il ne dit pas à qui appartient le texte, ni qui en répond.
- L'identité : il n'associe au texte ni une personne, ni un compte, ni une conversation.
- L'exactitude : il ne dit pas si le passage est vrai, trompeur ou bien contextualisé.
- L'absence de signal : elle ne prouve pas qu'un humain a écrit le texte, qui peut être trop court, modifié, traduit, produit par un modèle non couvert ou par l'outil d'une autre société.
Anthropic décrit les mêmes limites pour Claude : le filigrane établit que Claude a probablement participé au texte, sans distinguer « Claude a écrit » de « Claude a beaucoup retouché ».4 Anthropic marque ses textes dans le monde entier, faute de moyen durable pour limiter le marquage à une région.4 D'après la même source, les logiciels de détection d'IA du marché n'ont pas la clé de ce filigrane et analysent d'autres indices, comme des tournures de phrase.4
Search Engine Journal donne l'exemple d'une agence dont les rédacteurs, à Berlin et à Toronto, partagent le même abonnement ChatGPT : une partie de ses textes pourrait porter le filigrane d'OpenAI et l'autre non. Une clause de contrat qui prendrait un résultat de détection pour la preuve de l'auteur d'un texte poserait au filigrane une question à laquelle, selon OpenAI, il ne répond pas.2
03Google, le texte marqué et la relecture humaine
Les conseils de Google sur le contenu généré par IA portent sur l'exactitude, la qualité et la pertinence du contenu.5
Ce que Google demande déjà
Google écrit que l'IA générative peut aider à effectuer des recherches sur un sujet et à structurer un contenu original. Générer de nombreuses pages sans ajouter de valeur pour les utilisateurs peut en revanche enfreindre ses règles sur le spam et l'utilisation abusive de contenus à grande échelle.5
Google demande aussi de vérifier manuellement l'exactitude et la fiabilité de tout contenu généré par IA avant de le publier, y compris les éléments title, les meta descriptions, les données structurées et les textes alternatifs des images.5 Ces contrôles correspondent aux passes 3 à 5 de la relecture en cinq passes d'un contenu produit avec une IA, dont les deux premières portent sur les faits et les chiffres.
Ce que le filigrane ne contrôle pas
Le filigrane renseigne sur l'origine d'un passage. L'exactitude, que Google demande de vérifier avant publication, n'entre pas dans ce qu'il mesure : OpenAI écrit qu'un filigrane ne dit pas si un passage est vrai, trompeur ou bien contextualisé.1
La Commission définit la relecture humaine comme l'examen délibéré du fond du contenu par une ou plusieurs personnes qui ont les connaissances et le jugement professionnel du sujet. Elle écarte expressément les contrôles superficiels ou purement formels, comme la correction orthographique ou grammaticale.3
Dire comment un texte a été produit
Google invite aussi à partager des informations sur la façon dont un contenu a été créé, par exemple sur l'usage de l'automatisation, quand c'est pertinent pour l'audience.5 Sur sa page consacrée aux contenus utiles, la question « Comment » demande si l'usage de l'IA est évident pour les visiteurs et conseille d'ajouter des mentions là où le lecteur pourrait raisonnablement s'y attendre.6 La mention de l'usage d'une IA fait partie des contrôles de la signature honnête des pages d'une PME.